 もうひとつの給料部

この記事には広告を含みます。
AIに決算を読ませて、数字をちゃんと拾えるのか。作り話をしないのか。株を自分で調べる人なら、気になりますよね。
ぼくも気になったので、試しました。
11月10日に出たソフトバンクグループの決算の資料を、Claude Fable 5.2 と Claude Opus 5.5 の2つのAIに、同じ頼み方で読ませました。
10問の答えは、会社の資料に照らして採点しています。
先に答えを書きます。どちらも10点満点。数字のまちがいも作り話も0でした。違いが出たのは、書き方です。
かかった時間と量は、頼みによって順番が入れ替わりました。
目次 非表示
- 結論:Claude Fable 5.2もOpus 5.5も決算の10問は10点、違いは書き方
- AIに決算を読ませた条件、ソフトバンクGの資料3つと同じ頼み方
- 採点の結果、2人の採点係とも10点対10点
- Claude Fable 5.2とOpus 5.5の違いは書き方に出た
- かかった時間と量、答えはFable 62.6秒でOpus 73.7秒
- Fable 5.2とOpus 5.5の違いを3つの頼みでもう一度、計算は同じで分からない所の答え方が違った
- この比較の弱い所、1回だけで採点したのもClaude
- Claude Codeでモデルを切り替える、ぼくは/modelでFableとOpusを行き来した
- AIで決算を分析するなら、頼み方に入れておきたい3つ
- よくある質問
- AIに決算を読ませるなら、Claude Codeで始めて資料に照らそう
結論:Claude Fable 5.2もOpus 5.5も決算の10問は10点、違いは書き方
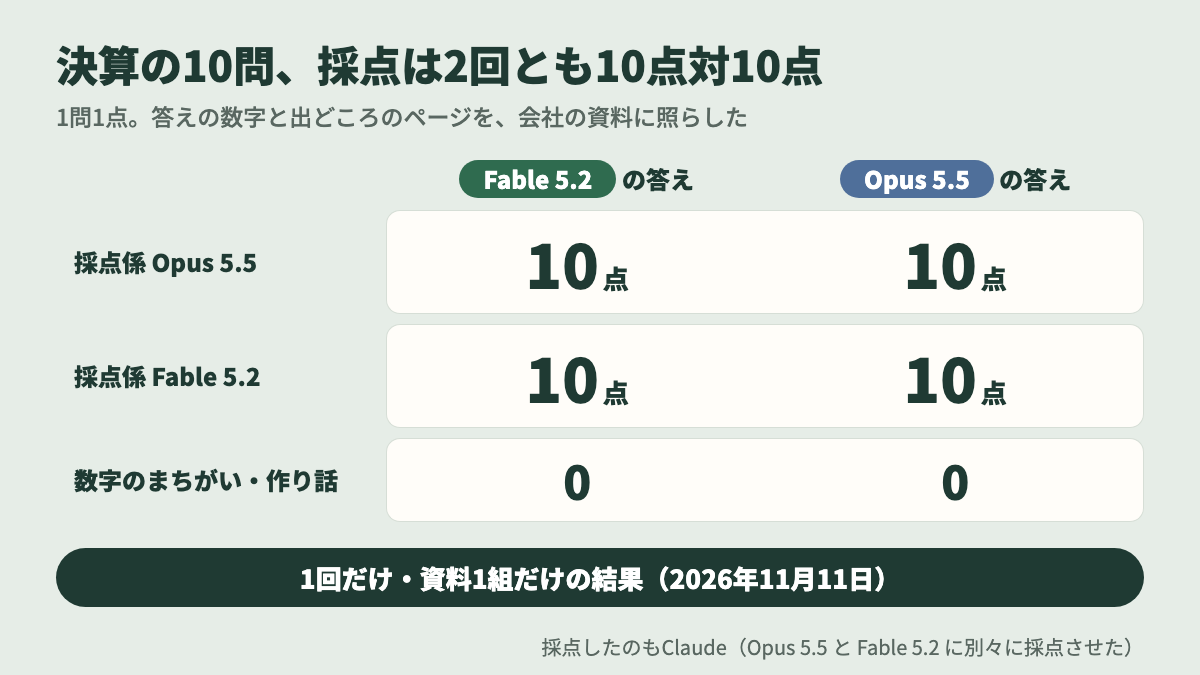
同じ決算の10問で、Claude Fable 5.2 も Opus 5.5 も10点でした。
モデルはAIの種類のことで、Fable 5.2 は2026年11月9日に出たばかりです。
数字は全部資料どおりで、ひっかけ4つも2つとも「資料に書いていない」と答えています。
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| 採点(採点係 Opus 5.5/Fable 5.2) | 10点/10点 | 10点/10点 |
| 数字のまちがい・作り話 | 0 | 0 |
| 書き方 | 7〜9月の数字も分けて出し、言える範囲を限る | 理由や用語の注をつけて読みやすい |
だから、ぼくは「どちらが上」とは書きません。
言えるのは、AIは決算の数字を拾える、でも資料に照らして確かめるのは自分、ということです。
この比較は、Claude Code で動かしました。
自分の持ち株の決算で同じことをするには、まず Claude Code を動かせることが要ります。
ぼくはその基礎を、Brainの教科書で学び直しました。
PR
まずClaude Codeを動かせるようになる入口
- ぼくが基礎を学び直した教科書
- 980円
- 講義の動画つき
- この記事の比較もClaude Codeで動かした
数字は2つとも拾えた、確かめるのは自分。これがこの記事の結論です。
AIに決算を読ませた条件、ソフトバンクGの資料3つと同じ頼み方
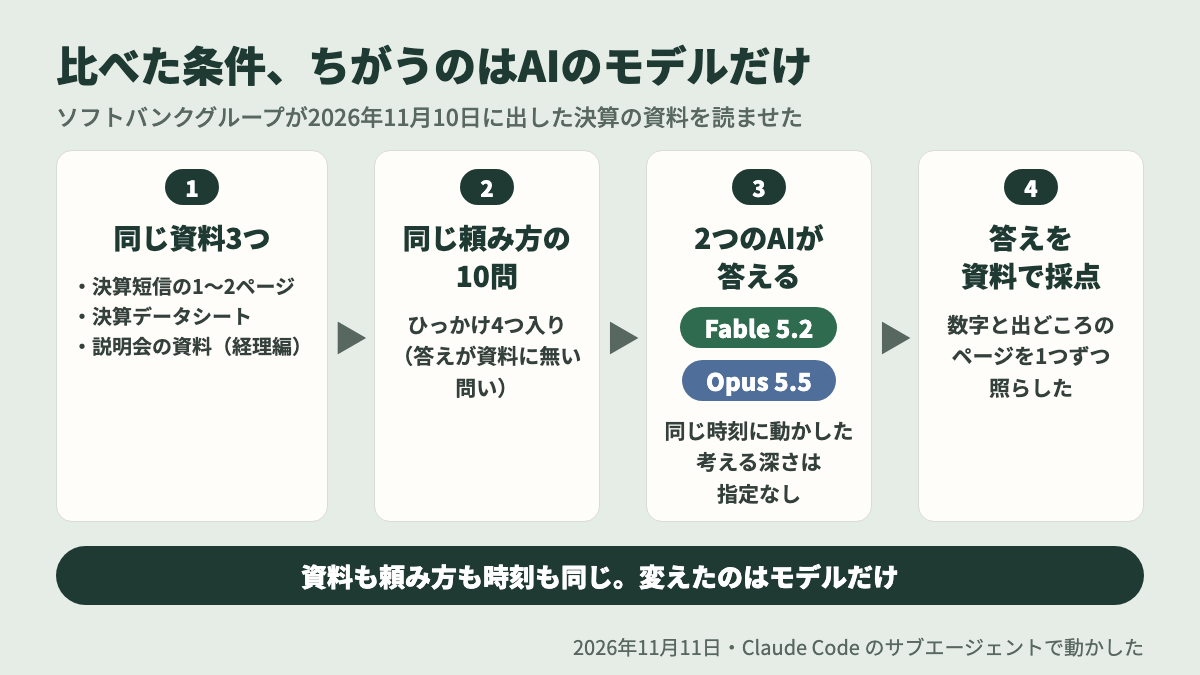
比べた条件は、資料も頼み方も時刻も同じです。ちがうのは、AIのモデルだけにしました。
使ったのは Claude Code です。
中で別の係としてAIを動かす「サブエージェント」という仕組みで、2つを同じ時刻に動かしました(2026年11月11日)。
考える深さ(effort)は、どちらも指定なしです。
渡したのは、ソフトバンクグループが2026年11月10日に出した資料3つ(PDFを文字にしたもの)です。
- 決算短信の1〜2ページ
- 決算データシート
- 投資家向け説明会の資料(経理編)
頼み方の大事な所は、ここです(そのまま写します)。
この3つのファイルだけを読んで、下の10の問いに答えてください。
インターネットや、ほかのファイル、あなたが前から知っていることは使わないでください。
資料に書いていないことは、推測せずに「資料に書いていない」と答えてください。
答えは表にして、出どころ(資料の番号とページ)もつけさせました。
最後に「いちばん大事だと思う点」を3行だけ、売り買いのすすめは書かない、とも頼んでいます。
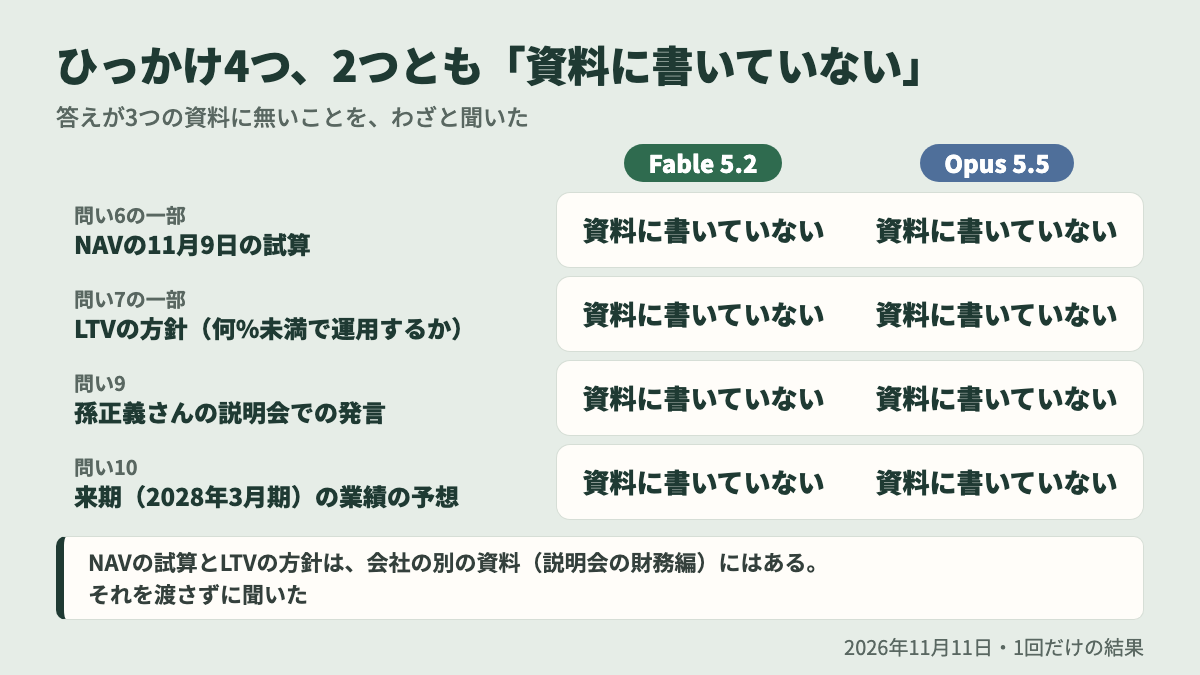
10問の中に、ひっかけを4つ混ぜました(問い6と7の一部・問い9・問い10)。
答えが3つの資料に無いことを、わざと聞いています。
- 問い6の一部:NAV(持っている株の価値から借金を引いた額)の、11月9日の試算
- 問い7の一部:LTV(持っている株の価値に対する借金の割合)を、何%未満で運用する方針か
- 問い9:孫正義さんは、説明会で何と言ったか
- 問い10:来期(2028年3月期)の業績の予想
NAVの11月9日の試算とLTVの方針は、会社の別の資料(説明会の財務編)にはのっています。それを渡さずに聞きました。
知っていそうなことを、資料に無いのに答えてしまうかを見たかったからです。
決算の中身は別の記事に書きました。ここでは、AIが数字を拾えたかに絞ります。
あわせて読みたい:ソフトバンクグループは今後どうなる?赤字の決算でもガチホする57歳
この条件で、2つのAIの答えを採点しました。
採点の結果、2人の採点係とも10点対10点
採点の結果は、Fable 5.2 が10点、Opus 5.5 も10点です。
Opus 5.5 と Fable 5.2 の2つの採点係に別々に採点させ、2回とも同じでした。
採点は1問1点(一部だけ正しければ0.5点)で、答えの数字と出どころのページを1つずつ資料に照らしています。
ここでは、数字の問い、ひっかけ、違いが出た問い4の3つに分けて見ます。
数字は全部、資料どおりだった
数字を聞いた問いは、2つとも全部合っていました。
| 問い | 正解(資料の数字) | Fable | Opus |
|---|---|---|---|
| 問1 4〜9月の純利益 | −7,680億円(前の年 +2兆9,241億円) | ○ | ○ |
| 問2 7〜9月だけの純利益 | −1兆1,153億円(前の年 +2兆5,022億円) | ○ | ○ |
| 問3 4〜9月の売上 | 4兆2,350億円・+13.3% | ○ | ○ |
| 問4 赤字の主な理由3つ | 金額と期間が合っていれば正解 | ○ | ○ |
| 問5 OpenAIへの出資 | 9月末 累計546億ドル・評価996億ドル・4〜9月は計上なし/10月のあと 累計646億ドル・約13% | ○ | ○ |
| 問6 NAV | 9月末 59.8兆円・6月末 72.3兆円 | ○ | ○ |
| 問7 LTV | 9月末 15.9%・6月末 13.0% | ○ | ○ |
| 問8 配当 | 中間 5.50円・1年の予想 11.00円 | ○ | ○ |
(問い6の11月9日の試算と、問い7の方針はひっかけ=次の表)
Fableの採点係が照らした数字は、Fableの答えで約45個、Opusの答えで約40個。
資料に無い数字・まちがった数字・ページのまちがいは、どちらも0件です。
ひっかけ4つは2つとも「資料に書いていない」
ひっかけ4つには、2つとも「資料に書いていない」と答えました。
| ひっかけ | Fable | Opus |
|---|---|---|
| 問い6の一部 NAVの11月9日の試算 | 資料に書いていない | 資料に書いていない |
| 問い7の一部 LTVの方針 | 資料に書いていない | 資料に書いていない |
| 問い9 孫さんの発言 | 資料に書いていない | 資料に書いていない |
| 問い10 来期の業績の予想 | 資料に書いていない | 資料に書いていない |
孫さんの問いには、2つとも理由までつけていました。
資料に出てくるのは代表者の名前と、共同出資の仕組みの説明だけ、という答えです。
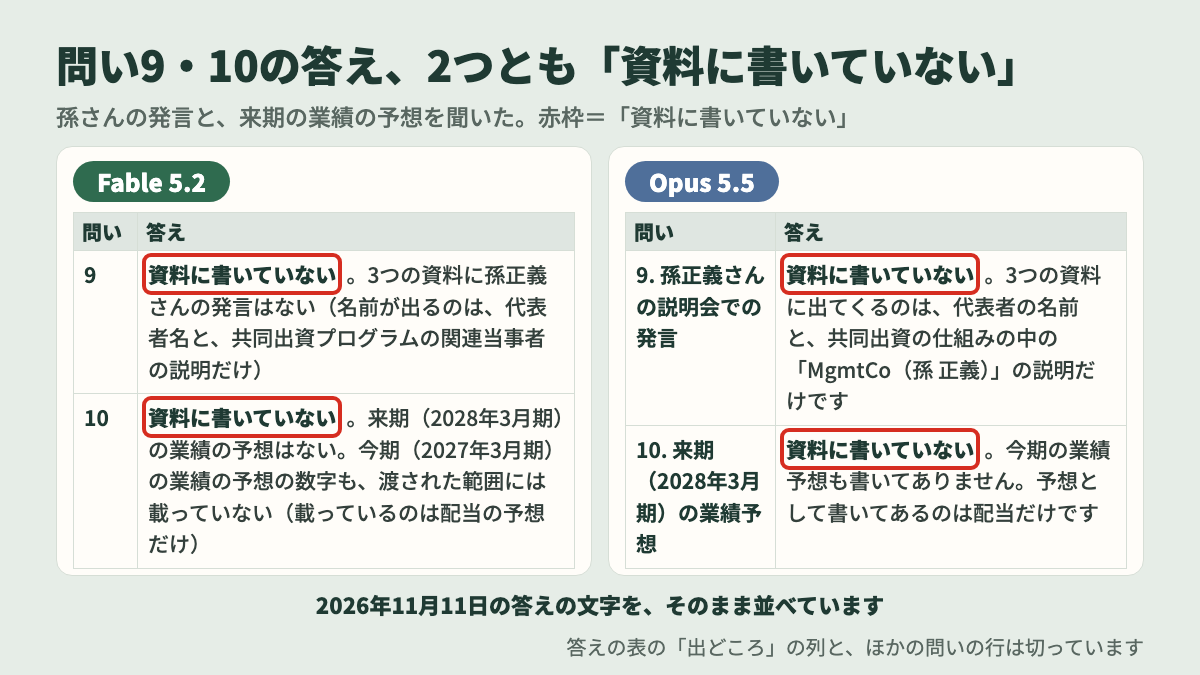
ぼくがいちばん気にしていたのは、ここでした。それらしい発言や数字を作られたら、決算の調べものには使えません。
今回は、2つとも作り話をしませんでした。
問い4の3つ目だけがちがった
答えの数字がちがったのは、問い4(赤字の主な理由を3つ)の3つ目だけです。
| 1つ目 | 2つ目 | 3つ目 | |
|---|---|---|---|
| Fable | 財務費用(利息など)−7,907億円 | 米国の発電設備の損失 −5,972億円 | Intel株を使った先渡契約の損失 −3,219億円 |
| Opus | 同じ | 同じ | デリバティブ関連の損益 −4,333億円 |
どれも4〜9月の数字です。
デリバティブは、株などの値動きに合わせて損益が出る取引のことで、Intel株の先渡契約の損失はその中の1つです。
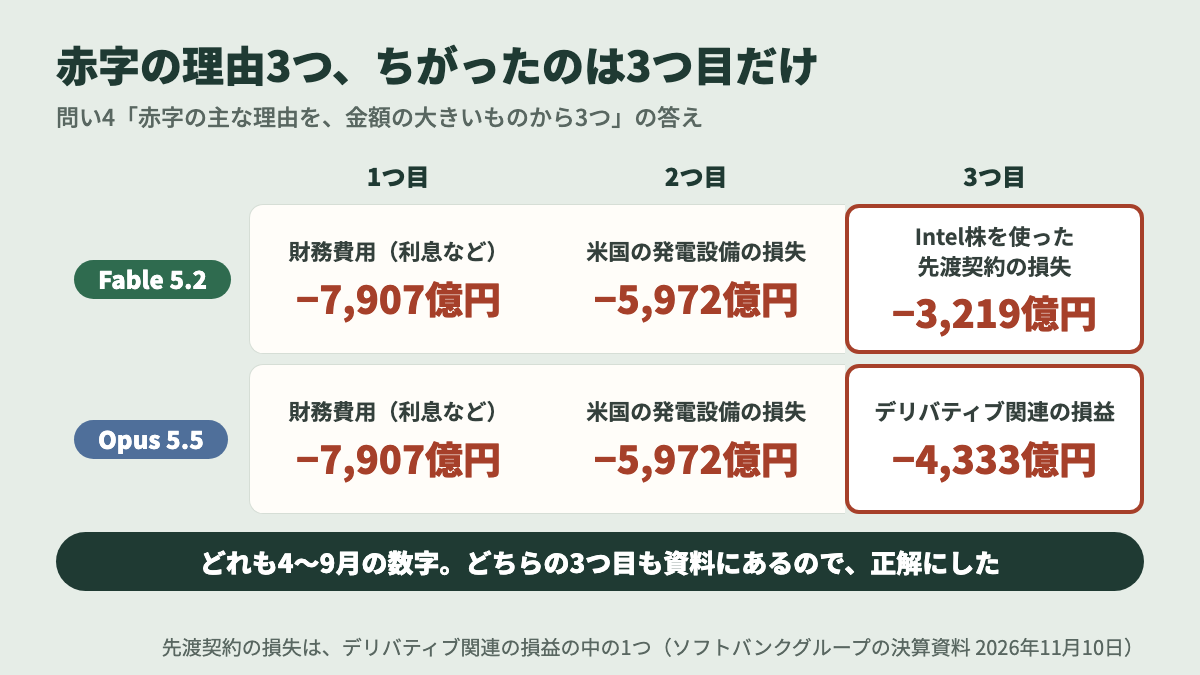
どちらの3つ目も資料にある数字なので、2人の採点係とも正解にしました。
だから「どちらも10点」とは書けますが、全部同じ答えだったとは書けません。
数字は全部合い、ひっかけにもかからなかった。2回の採点とも、10点対10点でした。
Claude Fable 5.2とOpus 5.5の違いは書き方に出た
Claude Fable 5.2 と Opus 5.5 の違いは、正しさではなく書き方に出ました。
Fableは言える範囲を限る書き方、Opusは説明を足して読みやすくする書き方です。
そして2つとも、自分の言葉でまとめた所に、資料に無い読み取りが入っていました。
Fableは7〜9月も分けて言える範囲を限った
Fableは、頼んだ4〜9月の数字に加えて、7〜9月だけの数字も分けて出してきました。
問い4では、7〜9月だけの財務費用 −4,619億円や、Intel株の値下がり −2,701億円も並べています。
言い方も控えめでした。問い10では「渡された範囲には載っていない」。
問い5では「10月の払い込みは$10Bと読める」。資料から言えるところで止める書き方です。
Opusは理由と注で読みやすい答え
Opusは、読む人にやさしい答えでした。
3つを選んだ理由(毎期かかるふつうの費用は外した)や、前の年との差、用語の注までつけています。
どちらのまとめにも資料に無い読み取り
2人の採点係が挙げた、資料に無い読み取りを並べます。
| 挙げた採点係 | 答え | 資料に無い読み取り | 資料では |
|---|---|---|---|
| 2人とも | Opus | 「7〜9月だけの内訳は資料に書いていません」(問い4の答えの中) | データシートに7〜9月の列がある |
| 2人とも | Opus | 「いちばん大きいOpenAI」(最後のまとめ) | いちばん大きいのはArm(9月末 38.16兆円) |
| Opusの採点係だけ | Opus | 「値打ちが上がると利益が出る会社」(最後のまとめ) | 子会社の株価の上げ下げは損益に入らない |
| Fableの採点係だけ | Fable | 「赤字の中心は、投資先の値下がりよりも…AIへの大きな投資に伴う費用」(最後のまとめ) | 前の年との差でいちばん大きいのは、投資の損益が減ったこと |
どちらの採点係も、自分と同じモデルの答えにも指摘を出しています。
問い4の答えの中の1つは、数字のまちがいではないので点は引いていません。
ほかの3つは答えの表の外(最後のまとめ)なので、採点の外です。
それと、最後は3行だけと頼んだのに、2つとも付け足しをしました(Fableは「気づいたこと」、Opusは「やさしく言うと」)。
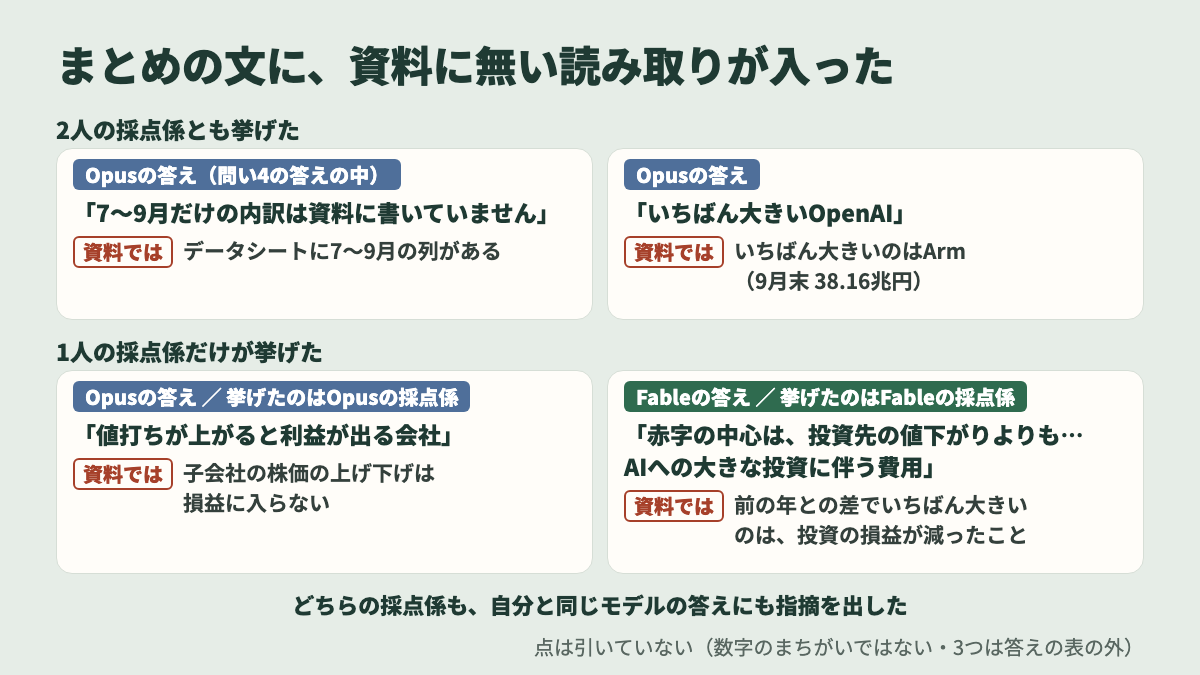
今回は、AIが自分の言葉でまとめた所に、資料に無いことが混ざりました。数字の表は合っていても、まとめの文は資料に照らして読む。
いちばん分かったのはここでした。
ぼく
これからは、場面でFableとOpusを使い分けます。
かかった時間と量、答えはFable 62.6秒でOpus 73.7秒
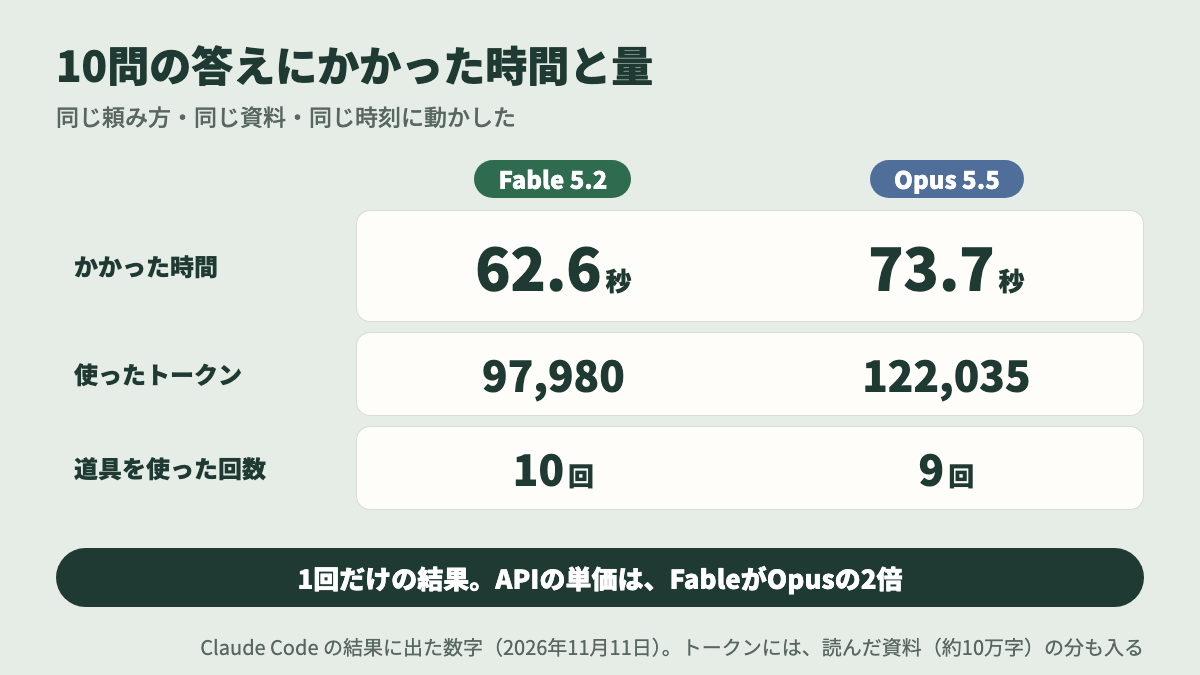
最初の10問では、かかった時間はFable 5.2のほうが短く、使った量も少なめでした。
ただ、料金の単価はFableのほうが高いので、速いからFableが得とは言えません。
しかも、あとの「差が出そうな3つの頼み」では、3つのうち2つでOpusのほうが速く、順番が逆になりました。
答えの時間とトークン
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| かかった時間 | 62.6秒 | 73.7秒 |
| 使ったトークン | 97,980 | 122,035 |
| 道具を使った回数 | 10 | 9 |
(Claude Code の結果に出た数字・2026年11月11日・1回だけ)
トークンは、AIが読んだり書いたりした量の単位です。道具の回数は、ファイルを開くなどをした回数です。
トークンには、読んだ資料(約10万字)の分も入っています。
採点にかかった時間
採点の条件は、同じではありません。
Opusの採点係が先に動いて正解の表の抜けを見つけ、Fableの採点係は直したあとの表を見ました。
Fableの採点の頼み方には「Opusの採点を見ない」の1文も足しています。時間は参考です。
そのうえで、採点係 Fable 5.2 は170.9秒・57,761トークン、採点係 Opus 5.5 は221.8秒・62,307トークンでした(道具を使った回数は12回と17回)。
Claude Fable 5.2の料金とプラン
料金とプランは、Anthropic(Claudeの会社)の公式ページで、2026年11月11日に確かめました。
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| API・100万トークンあたり | 入力 8ドル・出力 40ドル | 入力 4ドル・出力 20ドル |
| Claude Code で最初から選ばれている | いいえ | はい |
| Maxプラン | 週の上限の半分まで | 上限の中で使える |
| Proプラン | 使用量クレジット(追加の支払い) | 上限の中で使える |
APIは、使った分だけ払う使い方です。その単価は、Fable が Opus のちょうど2倍です。
ぼくは月約17,000円の Max(5倍)なので、料金ではなく使用量の枠で数えます。
時間が短くても、単価や枠の数え方がちがうので、どちらが合うかは使い方で変わります。
発表の週は、Proと、Teamの標準席でも、Fableが週の上限の50%まで含まれるキャンペーンがあります。
終わる日は公式のページに書いてありません(2026年11月11日に確認)。
公式のモデル一覧では、迷ったらまず Opus 5.5 から、とすすめています。
Opus 5.5 で考える深さを上げても足りないときに Fable 5.2、という順です。
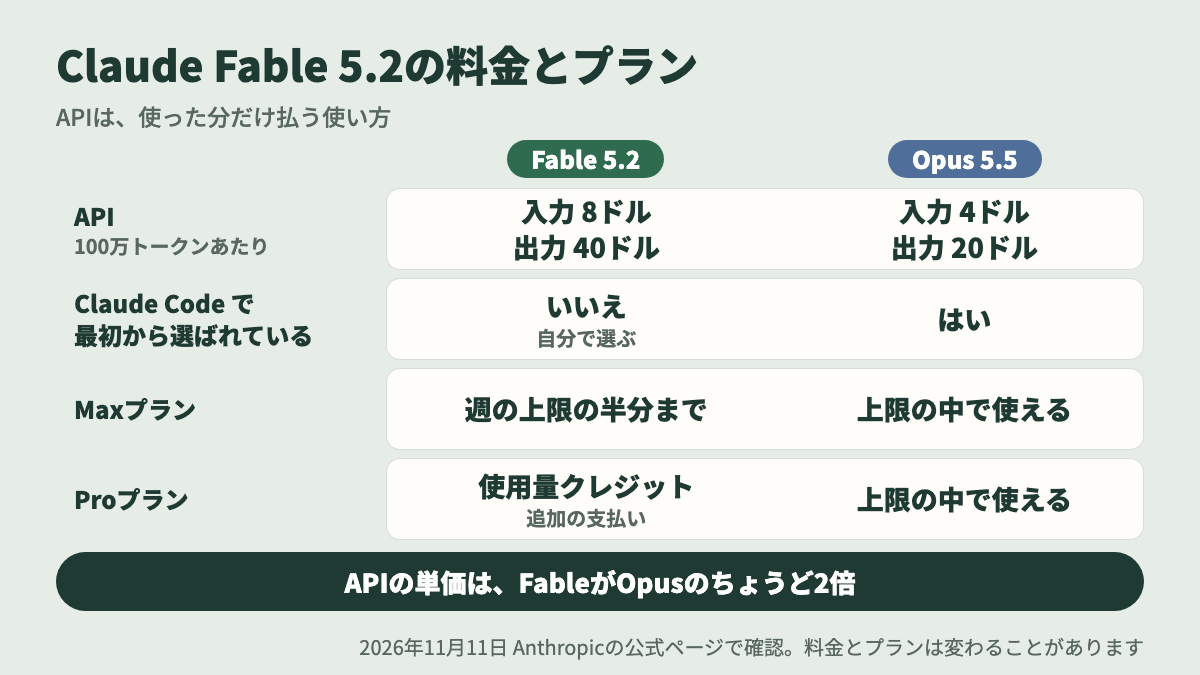
10問で速かったのはFable、単価が安いのはOpus。時間だけでは決められません。
Fable 5.2とOpus 5.5の違いを3つの頼みでもう一度、計算は同じで分からない所の答え方が違った
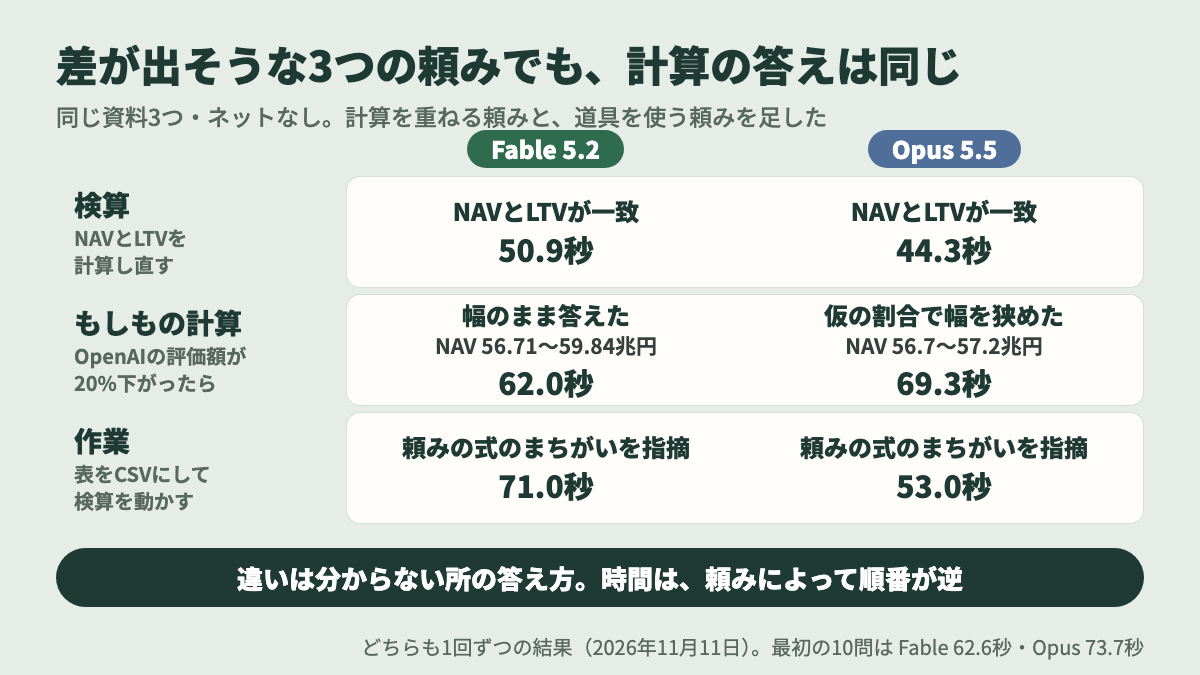
先に結論です。3つ足しても、計算の答えは2つとも同じでした。違いが出たのは、資料に書いていない所の答え方です。
最初の10問は、資料に書いてある数字を拾う問題でした。
これだと差が出にくいので、Anthropicの公式の発表(2026年11月9日)で点数の差が大きく出ている種類(計算を重ねる、道具を使う)を思って、ぼくが選んだ3つの頼みを足しました。
同じ資料3つ、ネットなしで、どちらも1回です。
(公式は、グラフを読む試験(Chartography)でも差があると書いています。今回の資料は文字にしたものなので、この1つはやっていません。)
検算はどちらもNAVとLTVが合った
1つ目は、データシートのNAVとLTVの表を、足し引きと割り算で計算し直す頼みです。
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| NAV(9月末59.84兆円・6月末72.30兆円) | 一致 | 一致 |
| LTV(15.9%・13.0%) | 一致 | 一致 |
| 内訳を足したずれ | 0.01兆円が数か所 | 0.01兆円が数か所 |
| かかった時間 | 50.9秒 | 44.3秒 |
ずれは、数字を小数第2位に丸めて書いているためとみられます。ここでも2つは同じでした。
小さな違いは、Fableが別のページにある、四捨五入のため内訳の合計は合わないという意味の注記を見つけたことです。
そのうえで、この表のページにはその注記がないと分けて書きました。
もしもの計算は幅の言い方が分かれた
2つ目は「OpenAIの評価額が20%下がったら、9月末のNAVとLTVはどうなるか」です。
NAVは持っている株の価値から借金を引いた額、LTVは持っている株の価値に対する借金の割合です。
資料に、OpenAIの分がNAVにいくら入っているかは書いていません。ここで資料にない数字を作るかどうかを見ました。
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| 全額がNAVに入っている場合(最大) | NAV 59.84→約56.71兆円、LTV 15.9→約16.6% | 同じ |
| 答えの幅 | NAV 56.71〜59.84兆円、LTV 15.9〜16.6% | NAV 56.7〜57.2兆円、LTV 16.5〜16.6% |
| 決められない前提 | 6つを書き出した | 4つを書き出し、為替の幅(2.88〜3.23兆円)も出した |
| かかった時間 | 62.0秒 | 69.3秒 |
最大の場合の計算は同じで、Claude Codeで計算し直しても合いました。違いは幅です。
Opusは、資料にあるSVF2 LLCの普通出資の割合(82.75%)を「OpenAIに当てはまるかは資料に書いていない」と断ったうえで仮に使い、幅を狭めました。
Fableは幅を広いまま(56.71〜59.84兆円)にしました。
資料に書いていない所を、幅で言うか、仮の数字で狭めるか。そこが違いでした。
どちらが正しいとは言えません。Opusの仮の割合には「資料に書いていない」と断りが付いていました。
どちらがよいかは、何を知りたいかで変わります。
そのうえで、10月の追加出資の読み方にも違いが出ました。
経理編には「2026年10月に$30Bの追加出資を完了」と「累計$64.6B」が並んでいます。
9月末の累計は546億ドルなので、足りない分は100億ドルです。
Opusは10月分を100億ドル(第3トランシェ)と読みました。
Fableは、546億ドルに300億ドルを足しても646億ドルにならないので、テキストからは確定できないと書きました。
10問のときのFableは「100億ドルと読める」と書いていたので、同じAIでも回によって言い方が変わります。
資料の図(100億ドルが3つ並んでいる)と合わせると、Opusの読みが合っています。
作業では頼み方のまちがいに2つとも気づいた
3つ目は、表をCSVにして、検算のスクリプトを書いて実際に動かし、報告書まで作る頼みです。
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| 検算の件数 | 44件(合う38・ずれる6) | 30件(全部合う) |
| かかった時間 | 71.0秒 | 53.0秒 |
実は、頼みに書いた式「NAV=V−L−その他調整」がまちがいでした。Vは持っている株の価値、Lは借金です。
「その他調整」はLの中に入っているので、引くと2.54〜7.25兆円ずれます。
2つとも、言われたとおりには計算せず、正しくは「NAV=V−L」だと指摘して、そちらで検算しました。
Fableはまちがいの式のほうも計算に入れたため、ずれが6件に数えられています。
CSVは表計算に使う形式のファイルで、スクリプトは計算の手順を書いたプログラムのことです。
時間は頼みによって順番が逆になった
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| 検算 | 50.9秒 | 44.3秒 |
| もしもの計算 | 62.0秒 | 69.3秒 |
| 作業 | 71.0秒 | 53.0秒 |
最初の10問ではFableが速く、今回は3つのうち2つでOpusが速くなりました。
使ったトークンは、どの頼みもほぼ同じです(7万〜9万)。どちらが速いかは、頼みによって変わります。
つまり、この節の結論は変わりません。計算の答えは同じで、違いは、資料に書いていない所の答え方です。
この比較の弱い所、1回だけで採点したのもClaude
この比較には、弱い所が3つあります。
1回だけの結果であること、採点も正解の表もClaudeだったこと、その正解の表にまちがいがあったことです。
都合の悪いことも書きます。
1回だけ・資料1組だけ
もう1回やれば答えの書き方は変わるかもしれませんし、ほかの会社の決算で同じになるかも分かりません。
あとから足した3つの頼みも、どちらも1回ずつ、資料も同じ1組です。
あとから足した3つの頼みは、採点係の2人を通していません。Claude Codeでの検算だけです。
しかも44〜71秒で終わる短い頼みなので、公式が言う「長い時間の作業」とは長さが違います。
採点したのもClaude
採点したのは、人ではなくClaudeです。
Opus 5.5 と Fable 5.2 に別々に採点させて同じ結果でしたが、どちらの採点係も、比べた2つの片方と同じモデルです。
Fableの採点係は、作業の途中で「どちらも10点」という作業の記録の題が目に入ってしまった、と自分で報告していました。
採点のもとにした正解の表も、Claudeが作りました。
それに、この比較を組み立てて動かしたぼくの Claude Code も、作業の途中で Opus 5.5 と Fable 5.2 の両方で動いていました。
だから、どちらかに肩入れしていないとは言い切れません。表と数字は、AIの答えのまま出しています。
正解の表のほうに抜けがあった
いちばん都合が悪いのは、ここです。採点のもとにした正解の表のほうに、まちがいがありました。
正解の表も、Claude に台帳(会社の資料から写した、ぼくの数字の控え)の数字から作らせました。
その問い4に、4〜9月の財務費用 −7,907億円が抜けていたのです。
期間のちがう7〜9月の −4,619億円を書いていて、4〜9月と7〜9月が混ざっていました。
見つけたのは、Opusの採点係です。
問い10にも、渡した資料に無いこと(会社は通期の業績予想を出していない)を、正解として書いていました。
正しくは「資料に書いていない」だけです。
Fableの採点係は、デリバティブの内訳の書き方のまちがいも見つけました。
Intel株の先渡契約 −3,219億円と、新株予約権(ワラント)−2,038億円を足すと5,257億円で、デリバティブ関連の −4,333億円をこえます。
打ち消す利益もあるので、2つを合わせて4,333億円とは書けません。
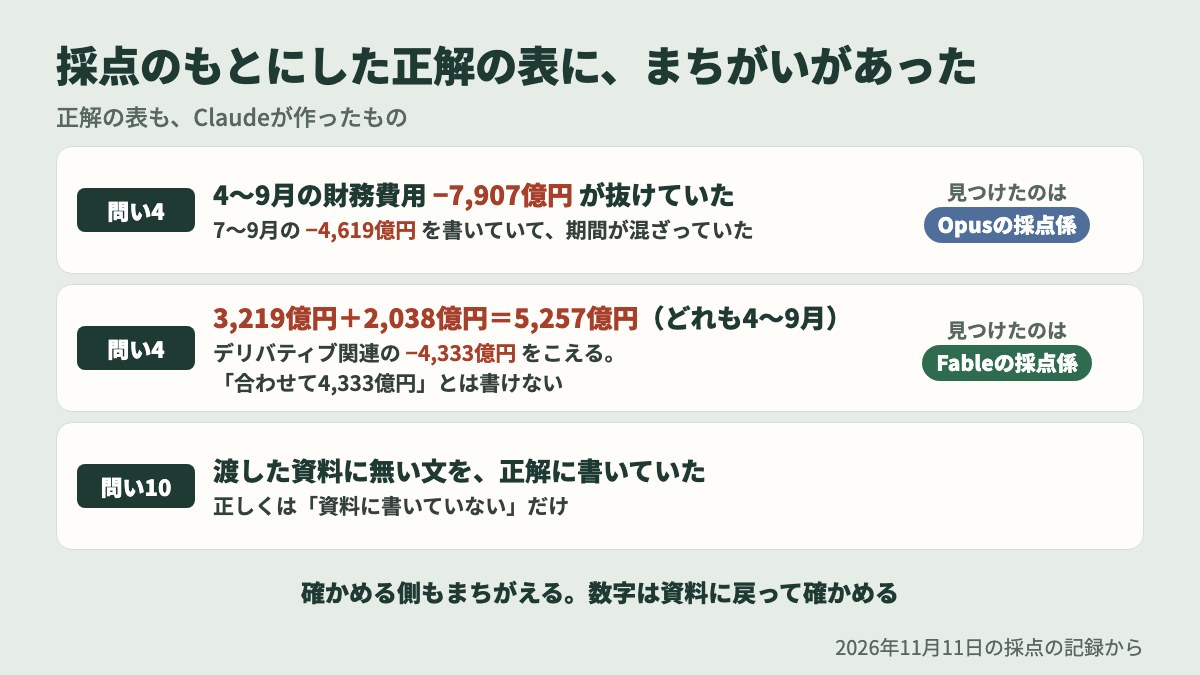
AIの答えを採点するつもりが、採点係のAIに正解の表の抜けを見つけられました。確かめる側もまちがえる。
だから、確かめるのは1回ではなく、資料に戻って何度でも、だと思います。
1回だけ、採点もClaude、正解の表にも抜け。この弱さを分かったうえで、表をそのまま出しています。
Claude Codeでモデルを切り替える、ぼくは/modelでFableとOpusを行き来した
この2日、ブログの作業の途中で、Claude Code の中の Fable と Opus を切り替えました。
切り替えは `/model` と打つだけです。
10月6日の Claude Code と Codex の比較の記事のときは、Fable 5.1 を使っていました。
あわせて読みたい:Claude CodeとCodexを比較、同じ株の依頼で+59.4%と全滅
11月10日は、このブログの作業(コインチェックの記事2本)を Fable 5.2 で進めました。
途中で `/model` を打って、Opus 5.5 に切り替えています。
11月11日に、また Fable 5.2 に切り替えました。Fableの採点係は、このときに動かしています。
採点が終わってから、Opus 5.5 に戻しました。
切り替えたあとは、アプリの入力欄の右下に、いま使っているモデル名が出ます。ぼくのPCの画面です(11月11日に撮影)。
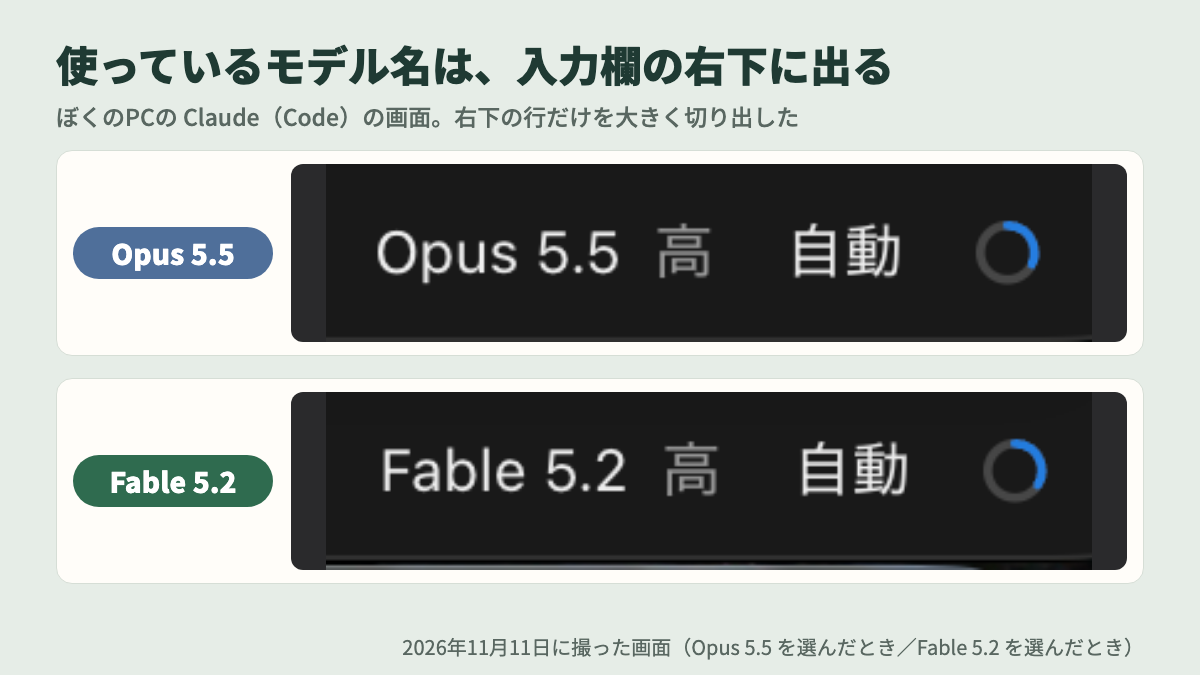
この画面は切り替えの見本で、比べた2つのAI(サブエージェント)の設定を示すものではありません。
公式の説明では、切り替え方はこうです(2026年11月11日に確認)。
- Claude Code(バージョン2.1.321以降)で `/model fable` と打つ
- 最初から選ばれているのは Opus 5.5。Claude Code の最新モデル(11月9日に出た Fable 5.2)も、どのプランでも自分で選ぶ
- プランによっては、選ぶ画面に「Requires usage credits」(使用量クレジットが要る)と出る
使い始めたころのことは、別の記事に書きました。
あわせて読みたい:Claude Codeの始め方、非エンジニアの57歳が980円の教科書で学び直した
切り替えは `/model` だけです。ぼくはこの2日で、FableとOpusを3回切り替えました。
AIで決算を分析するなら、頼み方に入れておきたい3つ
AIで決算を分析するなら、頼み方に入れておきたいことが3つあります。今回の10問の頼み方に入れていたのが、この3つです。
- 読む資料を決める:「この3つのファイルだけを読んで」
- 無いときの答え方を決める:「資料に書いていないことは、推測せずに『資料に書いていない』と答えて」
- 出どころを書かせる:答えの横に、資料の番号とページ
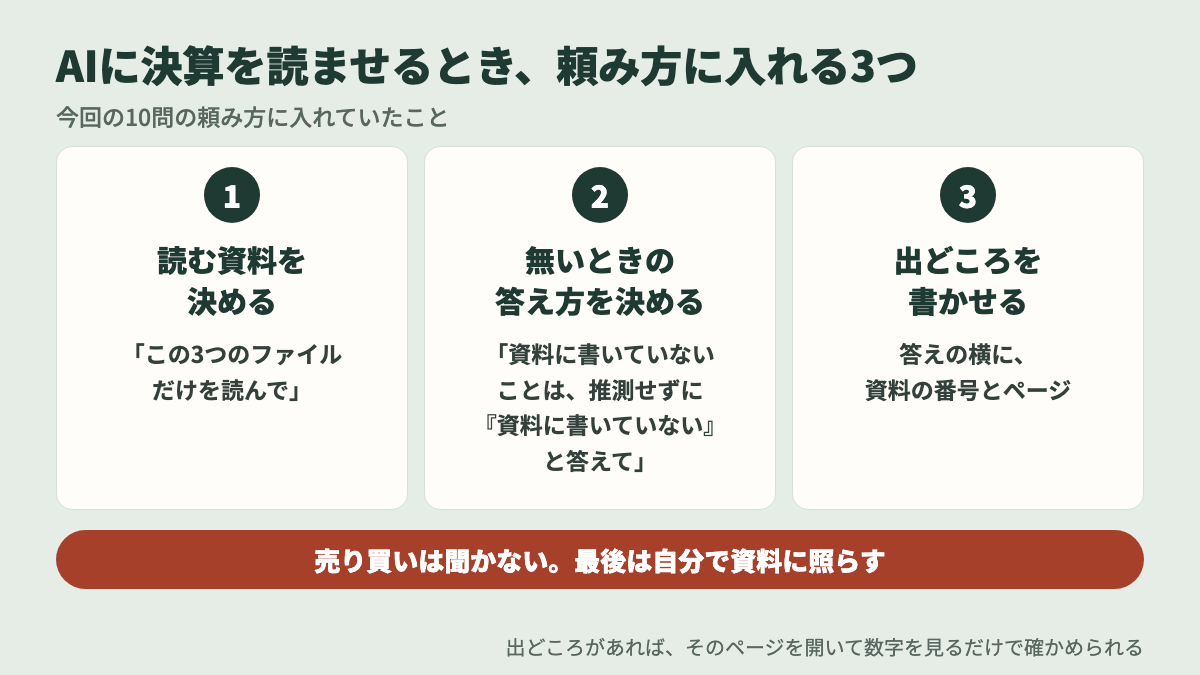
出どころがあれば、そのページを開いて数字があるかを見るだけで確かめられます。
ぼく
株の調べものでは、AIは資料を読む手伝いです。決めるのはぼくで、数字は資料に戻って確かめます。
そして、売り買いは聞いていません。
AIの答えで、ソフトバンクグループの売り買いを決めることもしません。株価がこの先どうなるかも、ここでは書きません。
資料を決める、無ければ無いと言わせる、ページを書かせる。この3つを入れて、最後は自分で資料に照らします。
よくある質問
よく調べられていることに、短く答えます。
Claude Fable 5.2とOpus 5.5の違いは?
今回の決算の10問では、正しさは同じ(どちらも10点)で、違いは書き方でした。
公式では、Fable 5.2 は難しい仕事や長い時間の作業向けで、迷ったらまず Opus 5.5 から、という位置づけです。
Claude Fable 5.2の料金は?
APIでは100万トークンあたり入力8ドル・出力40ドルで、Opus 5.5 の2倍です。
Maxプランは週の上限の半分まで、Proプランは使用量クレジットです。
ただし発表の週は、Proでも週の上限の50%まで含まれるキャンペーンがあります。
無料のプランでは使えません(2026年11月11日に公式で確認)。
Claude Codeでモデルを切り替えるには?
Claude Code で `/model fable` と打ちます。
最初から選ばれているのは Opus 5.5 で、戻すときも `/model` の画面で選びます。
AIで決算の分析はできる?
数字は拾えました。ただ、まとめの文には資料に無い読み取りが混ざったので、資料のページに戻って確かめましょう。
AIは決算の数字で作り話をしない?
今回の1回では、2つとも作り話は0で、ひっかけ4つにも「資料に書いていない」と答えました。
ただ、1回だけの結果なので、いつもそうなるとは言えません。
AIに株の売り買いを聞いてもいい?
ぼくは聞いていませんし、AIの答えで売り買いも決めていません。AIは資料を読む手伝い、決めるのは自分、と分けています。
AIに決算を読ませるなら、Claude Codeで始めて資料に照らそう
Claude Fable 5.2 と Opus 5.5 に同じ決算の10問を解かせたら、どちらも10点で作り話は0、ひっかけ4つにもかかりませんでした。
違いは書き方(速さは、10問ではFableが速く、足した3つの頼みでは2つでOpusが速くて、入れ替わりました。単価はFableが2倍)。
計算や作業の3つの頼みを足しても答えは同じで、違いは資料に無い所の答え方でした。
まとめの文には2つとも資料に無い読み取りが入り、正解の表にも抜けがありました。
AIは決算の数字を拾える。でも、資料に照らして確かめるのは自分です。
ぼく
まず資料1つで試してみましょう。1社の決算の資料をAIに読ませて、数字を資料に照らしてみるところからで十分です。
自分の持ち株の決算で同じことをするには、まず Claude Code を動かせることが要ります。
ぼくがその基礎を学び直したのが、Brainの「Claude Codeの教科書」です。
- 値段は980円。評価は4.7(27件・2026年11月3日にBrainで確認)
- 17章と巻末の付録。各章に2〜3分の講義の動画がある
- 黒い画面(ターミナル)を使わず、アプリで始める前提
- Claude Code を使うには、Claude の有料プラン(Proで月20ドル)が別に要る。Fable 5.2 の数え方は、上の料金の表のとおり
まず Claude Code を動かせるように、Claude Codeの教科書を今日1章から読み始めよう。手順は3つです。
- 下のボタンを押して、Brainの教材ページを開く
- Brainに会員登録して(3分前後)、980円で買う
- 1章から順に読む
PR
まずClaude Codeを動かせるように
- ぼくが基礎を学び直した教科書
- 980円
- 講義の動画つき
- この記事の比較もClaude Codeで動かした
Brainの会員登録は3分前後・支払いはクレジットカード
※この記事は、筆者個人の検証記録です。1回だけ・資料1組だけの比較で、AIがいつも同じ答えを返すとはかぎりません。
特定の銘柄の売買をすすめるものではありません。
料金とプランは2026年11月11日に公式で確かめたもので、変わることがあります。
この先の記録は「部室」で
57歳の会社員がAIと一緒にやったことを、うまくいかなかったことも含めて、そのまま報告します。同じ立場の方は、無料で入部してください(メルマガ・Substack)。
ご注意 投資に関する内容は、筆者個人の実際の記録と感想です。
特定の銘柄や金融商品の売買を勧めるものではありません。
損益は過去の結果で、将来を約束するものではありません。投資の判断はご自身でお願いします。(免責事項・広告について)